


Oblicz obciążenie transkrypcją, uwzględnij godziny szczytu i skaluj zasoby wraz z rozwojem.
Możesz dobrać wydajność 3CX AI Server do aktualnego zapotrzebowania i stopniowo ją zwiększać. Nie trzeba od razu kupować sprzętu na wszystkie przyszłe obciążenia.
Pierwszy serwer AI nie musi być jedynym serwerem, a każda centrala PBX nie potrzebuje dedykowanej maszyny. Jedna centrala PBX może korzystać z jednego lub kilku serwerów AI, a wiele central PBX może dzielić jeden serwer lub wspólną pulę zasobów.
Partner może na przykład współdzielić zasoby AI między klientami, aby lepiej je wykorzystać, a następnie dodawać serwery, zapewniając przestrzeń na rozwój i odporność na awarie. Z podobnej elastyczności korzysta firma z jedną dużą centralą PBX lub kilkoma systemami.
Niezależnie od sposobu wdrożenia metoda doboru wydajności pozostaje taka sama: oblicz liczbę nagrań do przetworzenia, dodaj zapas na rozwój w najbliższym czasie, sprawdź wydajność w najbardziej obciążonych okresach i rozbudowuj ją w miarę potrzeb. Opcje połączeń omówiono w artykule „Nadchodzące aktualizacje 3CX AI Server ”.
Oblicz rzeczywiste obciążenie
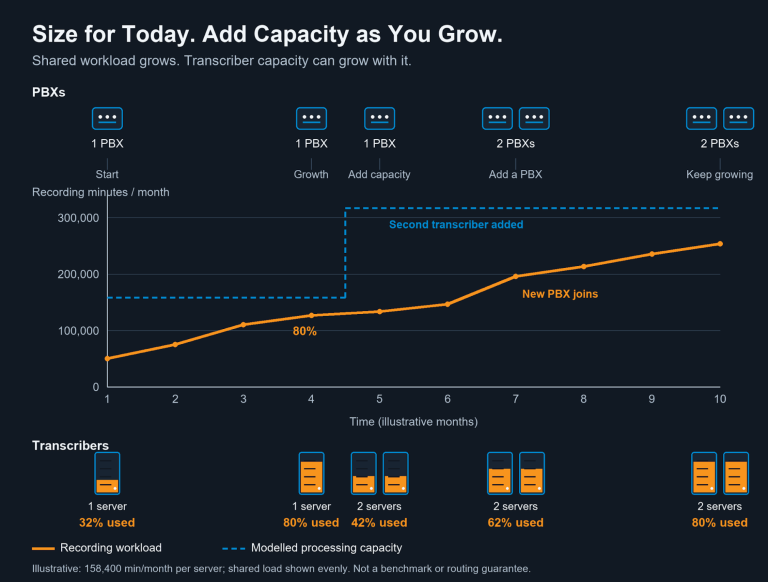
Przykładowa oś czasu: jeden serwer transkrypcji (AI Server) obsługuje początkowe obciążenie. Po osiągnięciu 80% jego wydajności dodawany jest drugi, co pozostawia zapas na dołączenie kolejnej PBX do wspólnej puli.
Dobieraj wydajność serwera AI pod kątem liczby minut nagrań rozmów i poczty głosowej przesyłanych do transkrypcji, a nie pod kątem całego ruchu telefonicznego.
Tylko te minuty zużywają zasoby serwera AI, a czas wyznaczony na ich przetworzenie decyduje o wymaganej przepustowości. Rozłożenie pracy na całą dobę generuje zupełnie inne wymagania niż konieczność ukończenia zadań w godzinach pracy biura, dlatego wybierz okno przetwarzania odpowiednie do świadczonej usługi. Nie zakładaj, że przetwarzanie nocne jest przydatne, jeśli użytkownicy oczekują wyników znacznie szybciej.
Jeśli kilka central PBX korzysta ze wspólnych zasobów AI, uwzględnij każdą z nich i prowadź osobne wyliczenia dla poszczególnych central, aby widzieć, jakie obciążenie wniesie nowy klient lub kolejny dział.
W tym przykładowym scenariuszu firma przesyła miesięcznie 50,000 minut nagrań do transkrypcji i chce je przetwarzać w ciągu 12 godzin każdego dnia roboczego. Daje to średnio około 189 minut nagrań na godzinę:
| Dane do określenia wydajności | Przykładowe obliczenie |
|---|---|
| Miesięczne obciążenie nagraniami | 50 000 minut |
| Dni robocze w miesiącu | 22 |
| Godziny przetwarzania w dniu roboczym | 12 |
| Dostępny czas przetwarzania | 22 x 12 = 264 godziny/miesiąc |
| Średnie obciążenie godzinowe | 50 000 / 264 = 189,4 min nagrań/godz. |
To średnie obciążenie godzinowe jest wartością bazową, którą w następnym kroku porównasz ze zmierzoną wydajnością serwera.
Porównaj zapotrzebowanie ze zmierzoną wydajnością
Następnie porównaj bazowe obciążenie z rzeczywiście zmierzoną przepustowością planowanego serwera, dodając zapas na rozwój.
Ogólne parametry sprzętu nie odzwierciedlają długości rozmów ani obciążenia związanego z analizą. Zmierz więc trwałą przepustowość na reprezentatywnych nagraniach obejmujących oba te elementy. Porównania sprzętu i objaśnienia pojęć Speed Factor oraz czasu odpowiedzi (round-trip time) znajdziesz w artykule „3CX AI Server – prędkość i czas reakcji”. Wymagania sprzętowe i systemowe zawiera instrukcja instalacji serwera AI. Zapas na rozwój pokazuje, czy serwer obsłuży wzrost obciążenia bez natychmiastowej rozbudowy.
Kontynuując poprzedni przykład: załóżmy, że sprzęt Twojego serwera AI osiąga zmierzony wskaźnik wydajności 10x Speed Factor, a planowany margines na rozwój wynosi 30%. Zastąp te dane własnymi pomiarami i oczekiwanym tempem wzrostu.
| Weryfikacja wydajności | Obliczenie | Wynik |
|---|---|---|
| Zmierzona wydajność (Speed Factor 10x) | 10 x 60 min | 600 min nagrań/godz. |
| Średnia + 30% wzrostu | 189,4 x 1,30 | 246,2 min nagrań/godz. |
| Planowane średnie wykorzystanie wydajności | 246,2 / 600 x 100 | 41,0% wydajności serwera AI |
| Zaobserwowane obciążenie w godzinie szczytu | Zmierzona wartość | 300 min nagrań/godz. |
| Godzina szczytu + 30% na rozwój | 300 x 1,30 | 390 min nagrań/godz. |
| Planowane wykorzystanie w godzinie szczytu | 390 / 600 x 100 | 65,0% wydajności serwera AI |
W tym przykładzie planowane średnie obciążenie zużywa 41% zmierzonej przepustowości, a godzina szczytu 65%, co oznacza, że serwer bez problemu poradzi sobie z zadaniami, zachowując bezpieczny zapas mocy. Sama średnia jest jednak tylko wstępnym sprawdzeniem, ponieważ może maskować nagłe spiętrzenia ruchu. Należy pamiętać, że powyższe wartości procentowe porównują zapotrzebowanie na transkrypcję ze zmierzoną przepustowością, nie oznaczają bezpośredniego obciążenia procesora (CPU) ani układu graficznego (GPU).
Sprawdź godziny szczytu i zachowaj zapas na awarię
Twój serwer AI musi radzić sobie w najbardziej obciążonych momentach i zwracać wyniki w akceptowalnym czasie nawet wtedy, gdy część zasobów stanie się niedostępna.
Kilku klientów może bez trudu mieścić się w miesięcznych limitach, przesyłając jednocześnie większość swoich nagrań w tych samych godzinach. Ponadto dłuższe rozmowy wpływają na czas ukończenia pojedynczych zadań. Margines na rozwój i odporność na awarie odpowiadają za dwa różne aspekty: margines pozwala obsłużyć więcej pracy, podczas gdy odporność wymaga zachowania wystarczającej mocy w sytuacji, gdy jeden z serwerów ulegnie awarii.
Powtórz więc weryfikację dla najbardziej obciążonego okresu, uwzględniając nakładające się na siebie szczyty z różnych central PBX korzystających ze wspólnych zasobów. Następnie przetestuj reprezentatywną partię połączeń w szczycie i sprawdź czas oczekiwania na wyniki. Kolejka, która rozładowuje się w akceptowalnym czasie, to zupełnie co innego niż kolejka, która bez przerwy rośnie. Na koniec przetestuj scenariusz obniżonej wydajności (przy niedostępnym jednym serwerze) pod kątem wymaganego czasu realizacji, zamiast zakładać, że każdy serwer będzie zawsze w pełni dostępny.
Jeśli kolejka się nie rozładowuje lub czas realizacji drastycznie spada przy ograniczonej wydajności, sprawdź okno przetwarzania, obciążenie lub dostępne zasoby, zanim dodasz kolejne zadania.
Zwiększaj moc wraz ze wzrostem zapotrzebowania
Przeliczaj wymagania za każdym razem, gdy zmienia się profil obciążenia, i dodawaj zasoby zanim serwer zacznie notować opóźnienia.
Dodanie nowej centrali PBX, objęcie nagrywaniem kolejnego działu czy stały wzrost biznesu – wszystko to zwiększa zapotrzebowanie na moc. Współdzielone serwery pozwalają zagospodarować wolne moce obliczeniowe pomiędzy różnymi systemami, a kolejne instancje transkrypcyjne (Serwery AI) umożliwiają płynną rozbudowę całej puli. Zróżnicowana pula maszyn nie zawsze skaluje się dokładnie proporcjonalnie do liczby serwerów, dlatego po każdej rozbudowie należy zmierzyć łączną przepustowość.
Schemat z początku artykułu pokazuje ten proces w praktyce: naturalny rozwój doprowadza pierwszy moduł do 80% jego limitu, drugi serwer tworzy zapas mocy, a powstała rezerwa przejmuje obsługę nowej centrali PBX dołączającej do wspólnego obciążenia. Próg 80% to jedynie przykład, a nie sztywna reguła. Zwiększaj wydajność odpowiednio wcześnie, aby zachować zaplanowane marginesy rozwoju i niezawodności.
Zacznij od obecnego zmierzonego obciążenia, uwzględnij realistyczny wzrost i regularnie kontroluj rzeczywisty czas przetwarzania przy zmianach obciążenia. W ten sposób Twoje zasoby AI będą rozwijać się harmonijnie wraz z klientami, bez konieczności ponoszenia nadmiarowych wydatków na sprzęt już pierwszego dnia.
Dołącz do dyskusji
Dołącz do rozmów na forach 3CX dla Partnerów lub Klientów. Obserwuj nas na X i LinkedIn, aby śledzić nowości i aktualizacje funkcji.
 Copyright © 2025